
Hành trình xây thuật toán chuẩn hoá dữ liệu báo cáo tài chính
Taxonomy engine trong vnstock_data 3.2.8 không xuất hiện từ một bản thiết kế hoàn chỉnh. Nó là kết quả của nhiều lần Vnstock thay đổi cách xử lý dữ liệu báo cáo tài chính: mỗi lần giải quyết được một bất tiện trước mắt, một hạn chế sâu hơn lại lộ ra.
Ở những phiên bản đầu tiên, cách làm khá đơn giản: API trả về trường nào, thư viện hiển thị gần như trường đó. Người dùng lấy được dữ liệu, nhưng muốn biết một con số thực sự mang ý nghĩa gì thì thường phải quay lại giao diện của website nguồn, dò vị trí của khoản mục trong báo cáo rồi tự xác định đâu là dữ liệu mình cần.
Sau những góp ý đầu tiên từ cộng đồng, tên tiêu chí được chuyển sang snake_case để dễ lưu trữ và sử dụng trong mã phân tích. Bảng dữ liệu nhìn gọn và thống nhất hơn, nhưng đó mới chỉ là chuẩn hoá cách viết. Khi tên gốc được biến đổi tự động, nhiều khoản mục khác nhau có thể trở thành cùng một tên. Quan hệ giữa dòng tổng và dòng chi tiết biến mất. Người dùng cũng không còn đủ thông tin để biết một tiêu chí nằm ở đâu trong cấu trúc báo cáo, thuộc cấp nào, dùng đơn vị gì hoặc có nên được xem là một khoản mục trọng yếu hay không.
Điều khiến mình trăn trở hơn là tên trường chưa có một bộ mã cố định. Chỉ cần API nguồn đổi cách đặt tên hoặc điều chỉnh cấu trúc phản hồi, tên tiêu chí trong đầu ra cũng có thể thay đổi theo. Nhà đầu tư phải tìm lại dữ liệu, còn lập trình viên khó duy trì một thuật toán ổn định qua nhiều phiên bản.
Vnstock đã thử bổ sung ánh xạ, mã định danh và các quy tắc xử lý để khắc phục từng vấn đề. Nhưng càng mở rộng, hạn chế cốt lõi càng rõ: chuẩn hoá báo cáo tài chính không thể chỉ dựa vào tên trường do từng nguồn cung cấp. Hệ thống cần một phương pháp đủ chặt để xác định mỗi khoản mục mang ý nghĩa gì, nằm ở đâu trong báo cáo, quan hệ với các khoản mục khác ra sao và có thể được đối chiếu thế nào giữa nhiều nguồn.
Taxonomy engine là kết quả của hành trình đó. Thay vì bắt đầu bằng câu hỏi “nguồn đang gọi trường này là gì?”, phiên bản 3.2.8 bắt đầu từ câu hỏi “khoản mục này là gì trong cấu trúc báo cáo tài chính?”. Bài viết này chia sẻ những quá trình phát triển và câu chuyện đằng sau mỗi quyết định đã dẫn Vnstock tới cách tiếp cận việc xử lý dữ liệu tài chính hiệu quả hơn.
Một bảng có dữ liệu chưa chắc đã sẵn sàng để phân tích
Vnstock là thư viện giúp lập trình viên kết nối tới dữ liệu chứng khoán từ công khai và các công ty chứng khoán hàng đầu thị trường. Danh sách cùng vai trò của từng tuyến kết nối được trình bày tại trang Nguồn dữ liệu của vnstock_data.
Với giá, khối lượng và thời gian giao dịch, các nguồn thường mô tả cùng một loại sự kiện. Tên cột có thể khác nhưng cấu trúc phía sau khá ổn định: một mã chứng khoán, tại một thời điểm, có giá và khối lượng tương ứng.
Báo cáo tài chính có thêm nhiều lớp ngữ cảnh:
| Khía cạnh | Giá và khối lượng | Báo cáo tài chính |
|---|---|---|
| Cấu trúc | Tương đối phẳng | Nhiều tầng tổng – chi tiết – giảm trừ |
| Khác biệt giữa ngành | Thấp | Lớn giữa doanh nghiệp, ngân hàng, chứng khoán và bảo hiểm |
| Tên gọi | Thường có thể đổi tên trực tiếp | Tên giống nhau vẫn có thể khác phạm vi hoặc khác bản chất |
| Thời gian | Liên tục theo phiên | Theo kỳ và có thể chịu tác động của phân loại lại, hồi tố |
| Căn cứ diễn giải | Quy ước thị trường | Khuôn khổ kế toán, cấu trúc báo cáo và bối cảnh công bố |
Hai nguồn cùng có dòng “Các khoản phải thu” chưa chắc đang nói về cùng một phạm vi. Một dòng mang giá trị 10.000 cũng chưa thể sử dụng nếu không biết đơn vị là đồng, nghìn đồng, triệu đồng hay phần trăm. Khi bảng bị làm phẳng, hai dòng cùng tên nhưng thuộc hai nhánh khác nhau còn có thể bị xem là một khoản mục trùng lặp.
Bài học đầu tiên của hành trình này là: đưa dữ liệu về máy người dùng chưa đồng nghĩa đã giúp họ sử dụng được dữ liệu. Nếu mỗi người vẫn phải mở website nguồn để dò lại ý nghĩa, chi phí diễn giải chỉ được chuyển từ thư viện sang người dùng cuối.
Phạm vi của thuật toán chuẩn hoá định dạng báo cáo tài chính trong Vnstock
Phiên bản vnstock_data 3.2.8 chủ yếu chuẩn hoá dữ liệu đã được các website phân tích số hoá và chia sẻ công khai trên Internet. Thuật toán không đọc lại hàng loạt báo cáo PDF thô để tạo dữ liệu từ đầu.
Điều này bỏ qua được bài toán trích xuất tài liệu với bảng lệch cột, chữ ký, dấu và lớp ký tự thiếu ổn định. Tuy nhiên, dữ liệu đã ở dạng bảng vẫn có thể khác nhau về cấp chi tiết, đơn vị, phạm vi báo cáo và cách hiểu khoản mục. Báo cáo gốc vì thế vẫn cần thiết để xác nhận bối cảnh và kiểm tra những trường hợp đáng ngờ.
Bốn giai đoạn thay đổi cách tiếp cận
Một thành viên trong cộng đồng Vnstock dùng tên GentleFlower8860 từng đặt câu hỏi rất thực tế trong bài chia sẻ trên nhóm cộng đồng về việc vì sao Vnstock phải tạo ra chuẩn dữ liệu BCTC.
“Đằng nào cũng đi crawl về thì mình cứ bê nguyên tên của họ thôi mà nhỉ.”
Nếu một người chỉ dùng một nguồn dữ liệu cố định và chấp nhận toàn bộ quy ước của nguồn đó, giữ nguyên tên trường là lựa chọn hợp lý. Nhưng khi tạo ra trải nghiệm đơn giản cho cộng đồng để người dùng khi muốn đổi nguồn mà không cần viết lại phần phân tích, Vnstock phải xác định được đâu là thông tin thuộc về bản chất khoản mục và đâu chỉ là cách trình bày riêng của từng website.
API trả gì, thư viện hiển thị gần như vậy
Mục tiêu ban đầu là giúp người dùng lấy được dữ liệu đã công khai qua API. Phản hồi của nguồn được làm phẳng thành bảng, còn tên tiêu chí được giữ gần với dữ liệu thô. Lựa chọn này giúp triển khai nhanh và dễ truy ngược về nguồn, nhưng người dùng phải tự mở website để hiểu vị trí, phân cấp, đơn vị và ý nghĩa của từng dòng.
Chuyển tên tiêu chí sang snake_case
Sau góp ý của cộng đồng, tên trường được làm sạch để thuận tiện cho lưu trữ và viết mã. Đầu ra gọn hơn nhưng cấu trúc báo cáo chưa được giữ lại. Khoản mục cha và con có thể trùng tên sau khi biến đổi; thứ tự, cấp bậc và đơn vị không đi cùng giá trị. Tên trường còn phụ thuộc vào phản hồi của API nên có thể thay đổi khi nguồn nâng cấp.
Tạo danh mục rút gọn và mã định danh ổn định
Một nhóm tiêu chí quan trọng được đưa vào danh mục có mã cố định để giảm tác động khi nguồn đổi tên. Cách này giúp mã phân tích ổn định hơn, nhưng lại mở ra câu hỏi khác: tiêu chí nào được chọn, danh mục cần rộng đến đâu, phần riêng của từng ngành được giữ thế nào và căn cứ nào cho phép xem hai trường là cùng một khoản mục?
Xây taxonomy dựa trên cấu trúc và ngữ cảnh
Cách tiếp cận được đảo lại: thay vì lấy tên trường của một API làm điểm xuất phát, Vnstock xây bộ phân loại khoản mục theo nhóm doanh nghiệp, khuôn khổ kế toán và cấu trúc báo cáo. Tên cùng mã của nguồn vẫn được giữ để truy vết, còn mã định danh trung tâm giúp đầu ra ít phụ thuộc hơn vào cách từng website trình bày.
Nhìn lại, những cách làm trước không sai trong bối cảnh của chúng. Mỗi phiên bản giải quyết vấn đề nhìn thấy rõ nhất ở thời điểm đó. Sai lầm chỉ xuất hiện nếu xem việc đổi tên, bổ sung ánh xạ hoặc tăng số lượng tiêu chí là lời giải cuối cùng.
Hành trình này giúp mình tách rõ bốn mức độ: đưa dữ liệu thành bảng, thống nhất cách viết, cố định mã định danh và chuẩn hoá ý nghĩa. Ba mức đầu giúp dữ liệu dễ dùng hơn. Mức cuối quyết định hai giá trị có thật sự được phép đặt cạnh nhau hay không.
Bước ngoặt: ngừng lấy một website làm chuẩn cuối cùng
Ở giai đoạn xây danh mục cố định, lựa chọn dễ nghĩ tới nhất là tìm nguồn có nhiều tiêu chí nhất rồi lấy toàn bộ cấu trúc đó làm chuẩn. Cách này giải quyết nhanh bài toán độ phủ nhưng tiếp tục buộc hệ thống phụ thuộc vào cách một website đặc thù tổ chức dữ liệu.
Sau nhiều lần nghiên cứu cách trình bày báo cáo do doanh nghiệp công bố, mình chú ý tới mã khoản mục và tên biểu mẫu ở góc báo cáo. Mã khoản mục gợi ra khả năng dùng một hệ mã làm id ghép nối và truy vấn dữ liệu. Tên biểu mẫu lại cho thấy một danh sách cột duy nhất không thể áp cho mọi loại hình doanh nghiệp.
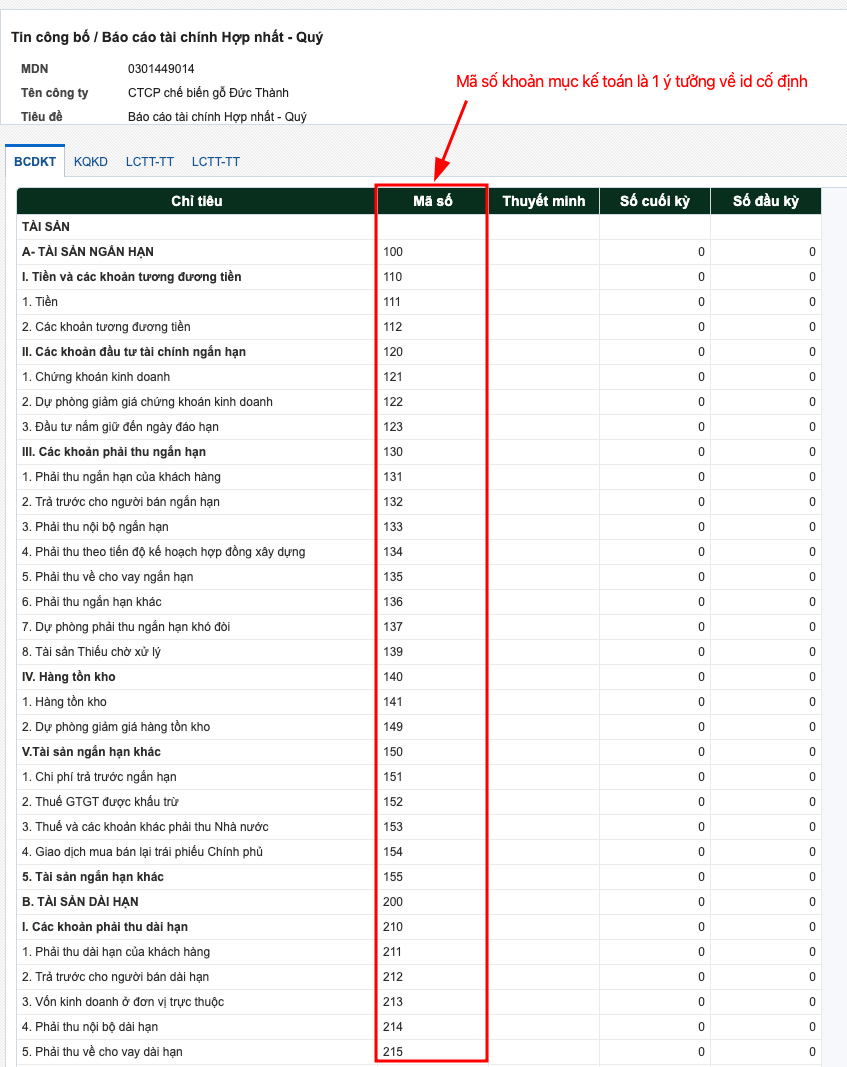 Minh hoạ: Ý tưởng khoản mục kế toán trong BCTC công bố tại website UBCK có thể làm id trong cơ sở dữ liệu. Mã chứng khoán được chọn ngẫu nhiên làm ví dụ.
Khi đặt báo cáo của doanh nghiệp thông thường cạnh ngân hàng, công ty chứng khoán và doanh nghiệp bảo hiểm, khác biệt không còn là vài tên cột. Mô hình kinh doanh quyết định báo cáo cần những nhóm khoản mục nào và chúng được tổ chức ra sao.
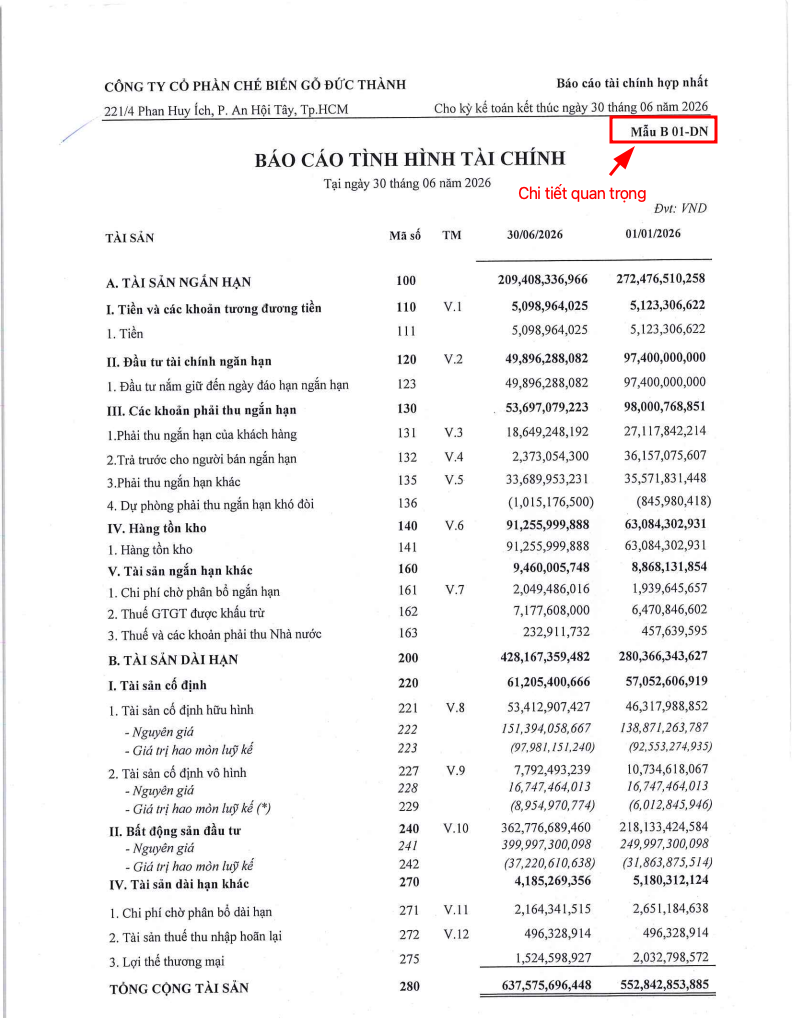 Thông tin biểu mẫu BCTC được áp dụng
Từ đây, câu hỏi thiết kế thay đổi. Vnstock không còn tìm một website để làm chuẩn tuyệt đối mà phải nối ba lớp thông tin: khuôn khổ kế toán để hiểu cấu trúc, báo cáo doanh nghiệp để xác nhận bối cảnh công bố và dữ liệu số hoá để phục vụ lập trình. Thuật toán chuẩn hoá là tổng hoà của ba lớp chức năng này.
Mốc 2016 trong tên các tiêu chí cho thấy tên trường cũng có lịch sử
Trong dữ liệu BCTC đã số hoá của VCI có những tiêu chí mang nhãn “trước năm 2016” hoặc “từ năm 2016”. Ban đầu, đây dễ bị xem như một quy ước đặt tên riêng của doanh nghiệp cụ thể hoặc bản thân VCI đề ra.
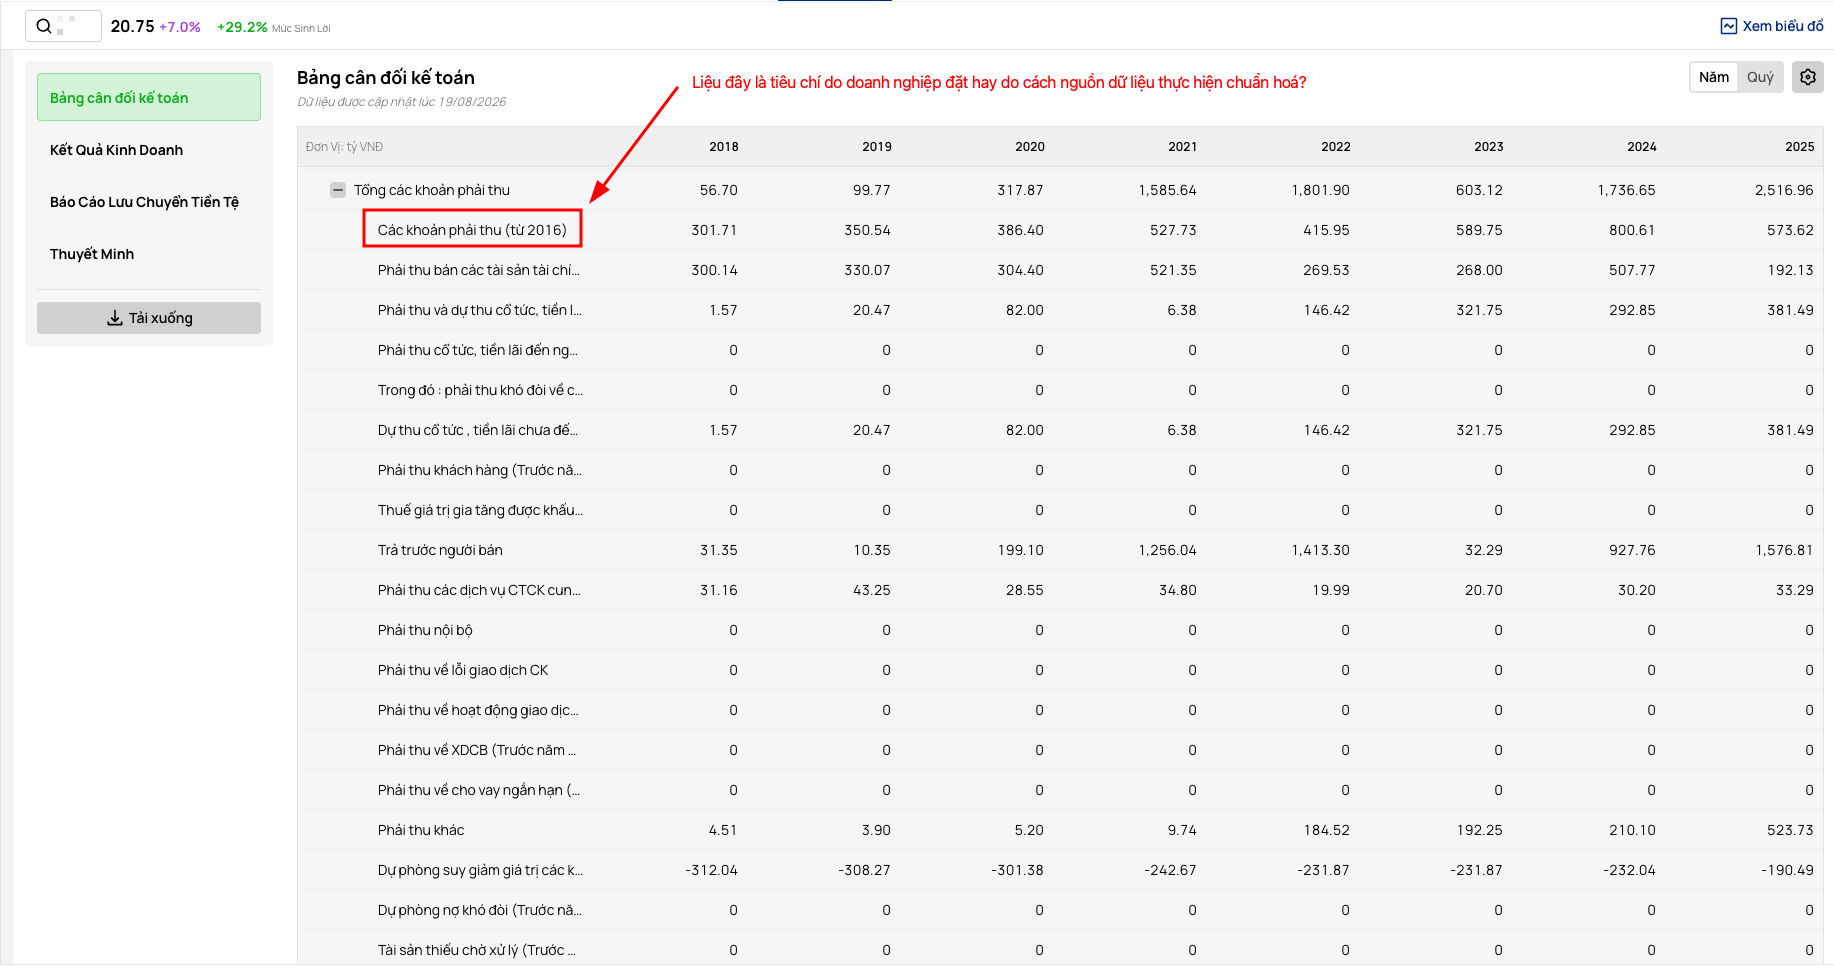 Tiêu chí cũ trong BCTC
Khi đối chiếu sâu hơn, mốc thời gian này dẫn tới những thay đổi trong chế độ kế toán và cách trình bày báo cáo của công ty chứng khoán. Nếu xoá hậu tố để gom hai trường về cùng một tên, chuỗi dữ liệu có thể trông liền mạch nhưng chứa hai phạm vi không còn tương đương. Nếu giữ mọi biến thể thành các chuỗi tách biệt, người dùng lại mất khả năng theo dõi một khoản mục chỉ thay đổi cách trình bày.
Insight ở đây rất cụ thể: tên trường không chỉ phụ thuộc vào nguồn, nó còn phụ thuộc vào thời điểm. Thuật toán chuẩn hoá vì thế phải giúp phân biệt thay đổi về cách viết với thay đổi về bản chất hoặc phạm vi của khoản mục.
Phần tiếp theo trình bày các lớp quyết định của thuật toán, cách Vnstock xử lý khác biệt ngành, điểm đứt gãy chuỗi thời gian và vai trò của AI trong quá trình đối chiếu. Gói Tài trợ giúp duy trì hoạt động phát triển, nghiên cứu và hỗ trợ cộng đồng; dữ liệu người dùng truy cập qua thư viện vẫn đến từ công ty chứng khoán và các nguồn công khai - trong đó Vnstock đóng vai trò là công cụ kết nối.
Điều mà thuật toán chuẩn hoá BCTC mới thực sự giải quyết
Phiên bản 3.2.8 đưa báo cáo tài chính từ nhiều cấu trúc theo nguồn về một hệ phân loại trung tâm, bao phủ hơn 1.700 khoản mục thuộc các báo cáo chính, thuyết minh và tỷ lệ của bốn nhóm doanh nghiệp.
Giá trị của thay đổi này không nằm ở việc tạo ra thêm một bảng dữ liệu “sạch”. Nó giảm phần diễn giải lặp lại mà trước đây mỗi người dùng phải tự làm, giữ mã phân tích ổn định hơn khi nguồn thay đổi và bổ sung ngữ cảnh cần thiết trước khi các con số được đặt cạnh nhau.
Taxonomy engine cũng không chọn cổ phiếu hay diễn giải báo cáo thay nhà đầu tư. Nó giải quyết một việc đứng trước các phép tính: giúp người dùng biết mình đang dùng khoản mục nào, thuộc cấu trúc nào, đo bằng đơn vị gì và có thể so sánh với dữ liệu nào.
Khi cần quay lại tài liệu công bố, người dùng có thể tham khảo hướng dẫn tra cứu và tải báo cáo tài chính mới nhất.
Bài tiếp theo trong loạt này đi từ cấu trúc dữ liệu mới sang các phương pháp phân tích báo cáo tài chính và những bẫy vẫn có thể làm sai lệch kết luận đầu tư: phân tích báo cáo tài chính bằng Python từ dữ liệu có cấu trúc.
Thảo luận
Đang tải…